8.Verifica ipotesi. Proporzioni
Study these flashcardsFree · spaced repetition · iPhone, Android, Mac & web
All cards
1
Verifica di ipotesi. Confronto tra poporzione campionaria e proporzione di popolazione.
Se la variabile oggetto di indagine è una variabile qualitativa, si lavora in termini di proporzioni.
Es. da una popolazione si estrae un campione di 300 elementi di cui 123 affetti da una certa malattia. La proporzione di soggetti malati è 123/300=0,41
$P$ è la proporzione della popolazione
$\hat{p}$ "p stimati" è la proporzione nel campione
Es. da una popolazione si estrae un campione di 300 elementi di cui 123 affetti da una certa malattia. La proporzione di soggetti malati è 123/300=0,41
$P$ è la proporzione della popolazione
$\hat{p}$ "p stimati" è la proporzione nel campione
2
Verifica di ipotesi. Confronto tra poporzione campionaria e proporzione di popolazione. Assunzioni e ipotesi statistiche
Assunzioni:
- variabile che conta il numero di successi sul numero delle prove segue una distribuzione binomiale
- Se $n \rightarrow \infty$ e $p \rightarrow 0,5$, è possibile approssimare una distribuzione binomiale a una distribuzione di Gauss
Ipotesi
$H_0: p = p_0$ con $p_0 =0,5$
la proporzione nella popolazione da cui è estratto il campione è uguale alla proporzione nella popolazione di riferimento
$H_1: p \neq p_0$
la proporzione nella popolazione da cui è estratto il campione è diversa
3
Verifica di ipotesi. Confronto tra poporzione campionaria e proporzione di popolazione. Statistica test z
Fomula generica di statistica test z
$z = \frac {variabile - media}{deviazione standard}$
In questo caso l'espressione diventa
$z = \frac {x - np_0 - 1/2}{\sqrt{np_0(1-p_0)}}=\frac{x -np_0 -1/2}{\sqrt{np_0q_0}}$
-1/2 è un fattore di correzione: la variabile è discreta
Dopo aver calcolato il valore della statistica test z, si procede confrontandolo con i valori di z tabulati per $\alpha/2$ (ricorda che ipotesi alternativa è bidirezionale e che nella tavola è riportato valore di $\alpha$ per una coda)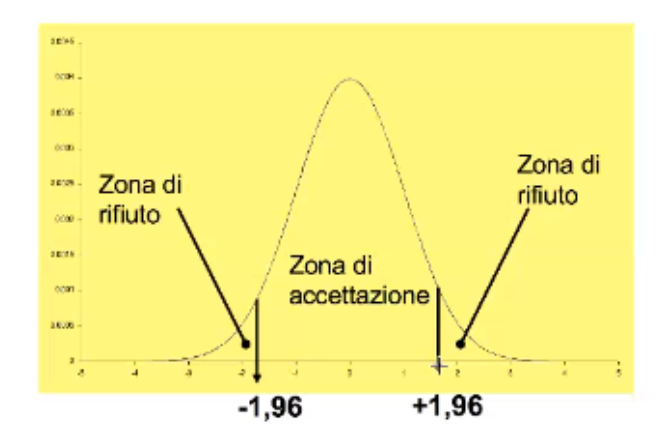
$z = \frac {variabile - media}{deviazione standard}$
In questo caso l'espressione diventa
$z = \frac {x - np_0 - 1/2}{\sqrt{np_0(1-p_0)}}=\frac{x -np_0 -1/2}{\sqrt{np_0q_0}}$
-1/2 è un fattore di correzione: la variabile è discreta
Dopo aver calcolato il valore della statistica test z, si procede confrontandolo con i valori di z tabulati per $\alpha/2$ (ricorda che ipotesi alternativa è bidirezionale e che nella tavola è riportato valore di $\alpha$ per una coda)
4
Verifica di ipotesi. Confronto tra due proporzioni. Assunzioni e ipotesi. Metodo parametrico
Es. si considerano due campioni: uno di pazienti trattati con una terapia, uno di pazienti trattati con un'altra terapia.
Assunzioni
- Campioni indipendenti
- Variabile relativa all'evento successo (n° di guariti) sul totale di soggetti trattati è una variabile qualitativa quindi ha distribuzione binomiale
- Risultano valide le condizioni $n \rightarrow \infty$ e $p \cong 0,5$ quindi la distribuzione binomiale si può approssimare a una distribuzione di Gauss
-> questo è fondamentale perché si possa utilizzare metodo parametrico
Ipotesi
$H_0: p_1 = p_2$ da cui $p_1 - p_2 = 0$
$H_1: p_1 \neq p_2$
5
Verifica di ipotesi. Confronto tra due proporzioni. Statistica test z (metodo parametrico)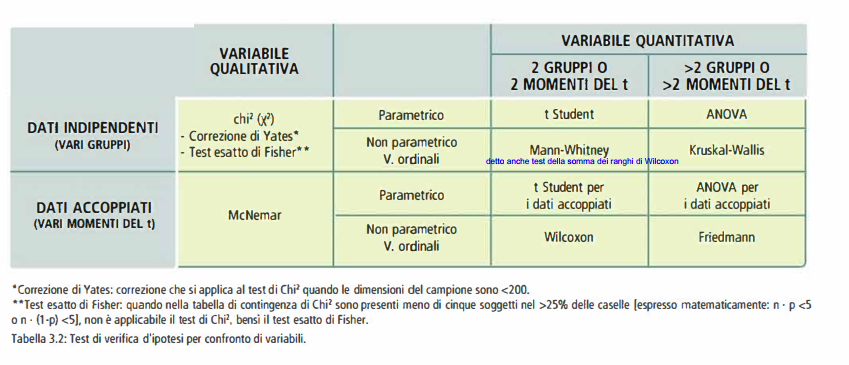
$z = \frac{(\hat{p}_1 - \hat{p}_2)- (p_1-p_2)}{\sqrt{\hat{p} (1-\hat{p})(\frac{1}{n_1}+\frac{1}{n_2})}}$
Poiché per l'ipotesi nulla si assume $p_1 - p_2 = 0$
$z = \frac{(\hat{p}_1 - \hat{p}_2)}{\sqrt{\hat{p} (1-\hat{p})(\frac{1}{n_1}+\frac{1}{n_2})}}$
$\hat{p}$ è la proporzione stimata ed è una proporzione cumulativa:
$\hat{p}=\frac{X_1+X_2}{n_1+n_2}$ con $X_1$= casi favorevoli del primo gruppo e $X_2$ = casi favorevoli del secondo gruppo
Dopo aver calcolato il valore della statistica test z, si confronta con il valore di z tabulato
6
Verifica di ipotesi. Confronto tra due proporzioni. Metodo NON parametrico. Assunzioni e ipotesi statistiche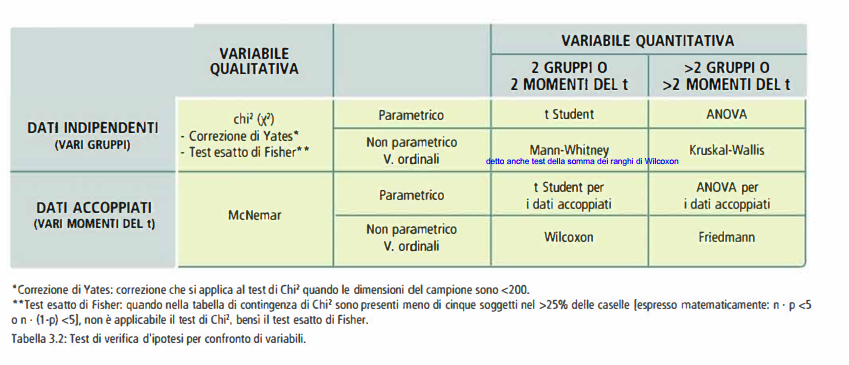
Assunzioni
- Campioni indipendenti
- La variabile è qualitativa ma in questo caso la distribuzione binomiale non è approssimabile a una distribuzione gaussiana
Ipotesi statistiche
$H_0: p_1=p_2$
$H_1: p_1 \neq p_2$
- Campioni indipendenti
- La variabile è qualitativa ma in questo caso la distribuzione binomiale non è approssimabile a una distribuzione gaussiana
Ipotesi statistiche
$H_0: p_1=p_2$
$H_1: p_1 \neq p_2$
7
Verifica di ipotesi. Confronto tra due proporzioni. Metodo NON parametrico.Costruzione della tabella 2x2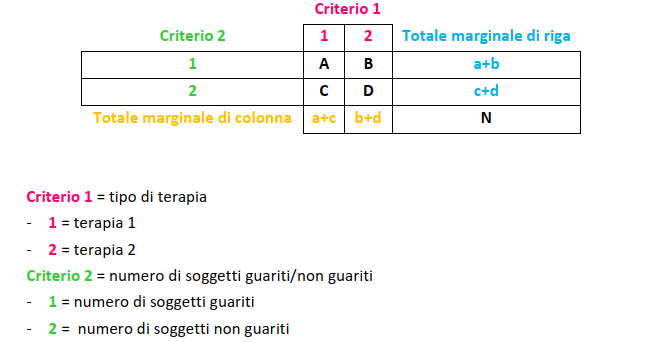
Tabella 2x2: ci sono due variabili e ciascuna variabile ha due livelli. Le righe della tabella rappresentano i risultati di una variabile e le colonne i risultati dell'altra.
(di solito è comodo inserire nelle colonne il tipo di trattamento)
(di solito è comodo inserire nelle colonne il tipo di trattamento)
8
Verifica di ipotesi. Confronto tra due proporzioni. Metodo NON parametrico. Statistica test $\chi^2$ (con Correzione di Yates) e confronto $\chi^2_{calcolato} vs \chi^2_{tab}$
$\chi^2=\frac{N(ad - bc)^2}{(a+b)(c+d)(a+c)(b+d)}$
Se a<5 o b<5 o c<5 o d<5 o N<30, si utilizza la Correzione per la continuità di Yates:
$\chi^2= \frac{N(\left | ad-bc \right |-0,5N)^2}{(a+b)(c+d)(a+c)(b+d)}$
Dopo aver calcolato $\chi^2_{calcolato}$ si confronta con $\chi^2_{tab}$, che in caso di tabella 2x2 va ricercato in corrispondenza di g.l.=1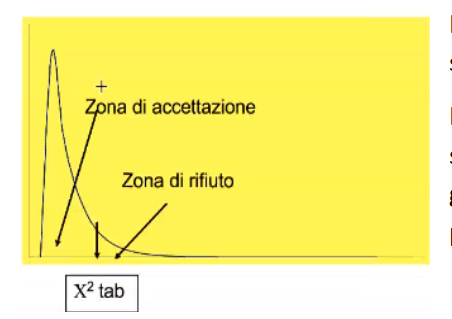
Se a<5 o b<5 o c<5 o d<5 o N<30, si utilizza la Correzione per la continuità di Yates:
$\chi^2= \frac{N(\left | ad-bc \right |-0,5N)^2}{(a+b)(c+d)(a+c)(b+d)}$
Dopo aver calcolato $\chi^2_{calcolato}$ si confronta con $\chi^2_{tab}$, che in caso di tabella 2x2 va ricercato in corrispondenza di g.l.=1
9
Verifica di ipotesi. Confronto tra più proporzioni.
Nel caso di tabelle di contingenza 2 x k (variabili qualitative dicotomiche con k gruppi a confronto), il test $\chi^2$ può essere usato per verificare
$H_0: p_1 = p_2 = ... = p_k = p$
$H_1: p_r \neq p_s $
La statistica test diventa
$\chi^2= \sum_{ij}\frac{(O_{ij}-E_{ij})^2}{E_{ij}}$ ha una distribuzione $\chi^2$ con k-1 gradi di libertà
v. anche in seguito
$H_0: p_1 = p_2 = ... = p_k = p$
$H_1: p_r \neq p_s $
La statistica test diventa
$\chi^2= \sum_{ij}\frac{(O_{ij}-E_{ij})^2}{E_{ij}}$ ha una distribuzione $\chi^2$ con k-1 gradi di libertà
v. anche in seguito
10
Relazione tra variabili
Si possono genericamente distinguere due casi:
- Relazione tra variabili qualitative (o quantitative divise in classi) -> Tabelle di contingenza
- Relazione tra variabili quantitative -> Regressione e correlazione
- Relazione tra variabili qualitative (o quantitative divise in classi) -> Tabelle di contingenza
- Relazione tra variabili quantitative -> Regressione e correlazione
11
Relazione tra variabili qualitative (o quantitative divise in classi). Costruzione tabella valori O (osservati)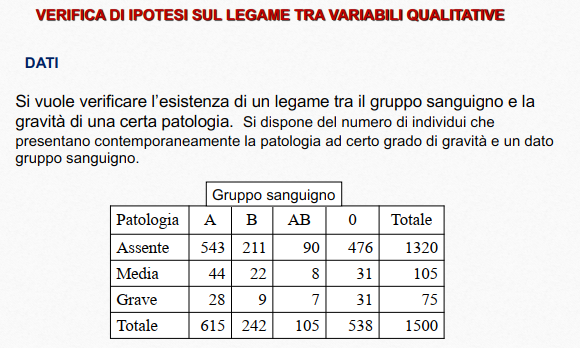
L'ipotesi da verificare in questo caso è:
$H_0$= indipendenza
$H_1$= dipendenza
I dati possono essere riassunti all'interno di una tabella di frequenza a doppia entrata, detta tabella di contingenza caratterizzata da $r$ righe e $c$ colonne
Ogni elemento nella tabella viene indicato come $O_{ij}$
Il primo pedice ($i$) indica il numero di riga, il secondo pedice ($j$) indica il numero di colonna.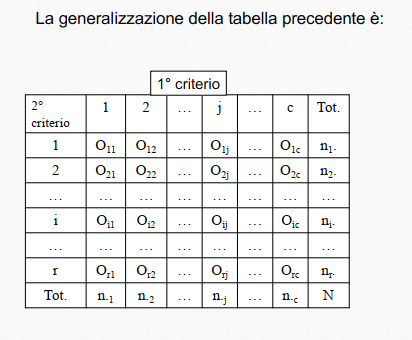
$H_0$= indipendenza
$H_1$= dipendenza
I dati possono essere riassunti all'interno di una tabella di frequenza a doppia entrata, detta tabella di contingenza caratterizzata da $r$ righe e $c$ colonne
Ogni elemento nella tabella viene indicato come $O_{ij}$
Il primo pedice ($i$) indica il numero di riga, il secondo pedice ($j$) indica il numero di colonna.
12
Relazione tra variabili qualitative (o quantitative divise in classi). Verifica di ipotesi (1). Assunzioni e ipotesi
Assunzioni
Le variabili di cui disponiamo sono qualitative.
Considerando una singola cella si può assumere una distribuzione binomiale (rappresenta il successo su un certo numero N di prove).
I dati in tabella nel loro insieme seguono una distribuzione multinomiale.
Ipotesi
$H_0: p_{ij}= p_i \times p_j$
con $ p_{ij}$ = probabilità di una cella
$p_i$ = probabilità di riga
$p_j$ = probabilità di colonna
Perché? Ricordando dal capitolo delle probabilità: dati due eventi A e B tra loro indipendenti, la probabilità che essi si verifichino contemporaneamente è data dalla legge del prodotto $P(B\cap A) = P(A) \cdot P(B)$
$H_1: p_{ij} \neq p_i \times p_j$
13
Relazione tra variabili qualitative (o quantitative divise in classi). Verifica di ipotesi (2). Costruzione della tabella dei valori E (expected= attesi)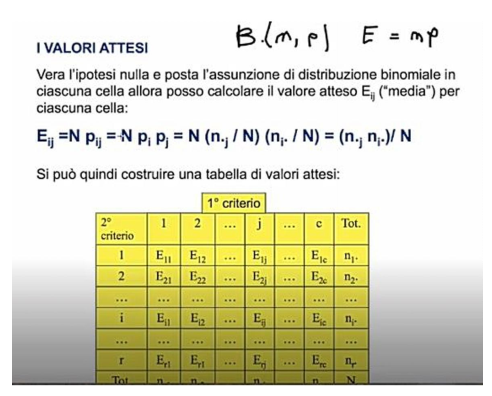
Si costruisce la tabella dei valori attesi inserendo in ogni cella
$E_{ij}= \frac{n_in_j}{N}$
Dimostrazione:
In ogni cella vi è una distribuzione binomiale.
Nella distribuzione binomiale la frequenza di un valore è data da $n \cdot p$, possiamo affermare che il valore atteso in ogni cella è $E_{ij}=N \cdot p_{ij}$
Data per vera l'ipotesi nulla (la verifica di ipotesi si conduce "sotto ipotesi nulla"), $p_{ij}=p_ip_j$.
Pertanto $E_{ij}=N \cdot p_i \cdot p_j$
Sostituendo $p_i= \frac{n_i}{N}$ e $p_j=\frac{n_j}{N}$
Si ha $E_{ij}=N \cdot \frac{n_i}{N} \cdot \frac{n_j}{N}=\frac{n_in_j}{N}$
In una tabella che ha $r$ righe e $c$ colonne, non è necessario tutti gli $r \cdot c$ elementi, ma basta calcolarne $(r-1)(c-1)$
$(r-1)(c-1)$ rappresenta i gradi di libertà della tabella.
14
Relazione tra variabili qualitative (o quantitative divise in classi). Verifica di ipotesi (3). Statistica test $\chi^2$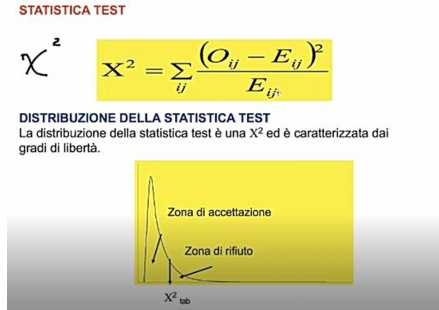
Si procede con l'esecuzione della statistica test $\chi^2$
$\chi^2= \sum \frac{(O_{ij}-E_{ij})^2}{E_{ij}}$
Se nella tabella dei valori attesi <5 o se $N$ è molto piccolo, si impiega la correzione per la continuità di Yates:
$\chi^2= \sum \frac{(|O_{ij}-E_{ij}|-0,5N)^2}{E_{ij}}$
Dopo aver calcolato $\chi^2_{calcolato}$, si confronta con $\chi^2_{tab}$.
Se minore -> zona di accettazione
Se maggiore -> zona di rifiuto
Ricordare che in questo caso g.l.=(r-1)(c-1)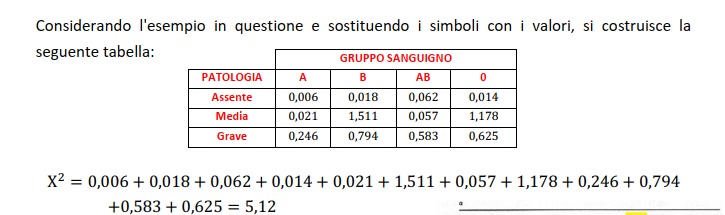
$\chi^2= \sum \frac{(O_{ij}-E_{ij})^2}{E_{ij}}$
Se nella tabella dei valori attesi <5 o se $N$ è molto piccolo, si impiega la correzione per la continuità di Yates:
$\chi^2= \sum \frac{(|O_{ij}-E_{ij}|-0,5N)^2}{E_{ij}}$
Dopo aver calcolato $\chi^2_{calcolato}$, si confronta con $\chi^2_{tab}$.
Se minore -> zona di accettazione
Se maggiore -> zona di rifiuto
Ricordare che in questo caso g.l.=(r-1)(c-1)
15
Relazione tra variabili qualitative (o quantitative divise in classi). Test di McNemar: generalità
Il test di McNemar si utilizza per variabili qualitative (proporzioni) in campioni appaiati. Si sottopone un elemento al giudizio di due sistemi diversi: il senso di questo test sta nella ricerca della ripetibilità e riproducibilità di una misura (es. esame obiettivo sul fegato o più in generale qualunque procedura operatore-dipendente).
16
Relazione tra variabili qualitative (o quantitative divise in classi). Test di McNemar: assunzioni e ipotesi statistiche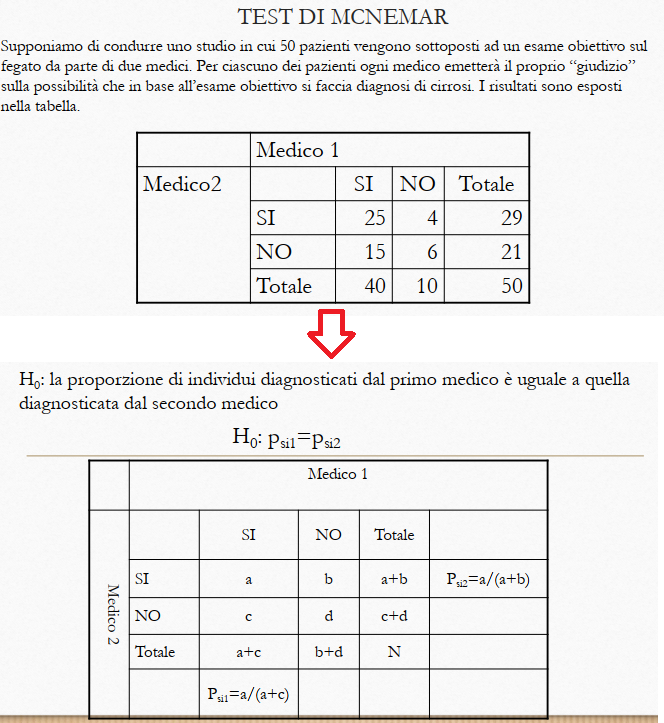
Assunzioni:
- campioni appaiati
- variabile dicotomica
- dati categorici
Ipotesi statistische
Le ipotesi statistiche si costruiscono sulle frequenze marginali. Le coppie concordanti non forniscono alcuna informazione. Ci concentriamo sulle coppie discordanti per testare l'ipotesi nulla.
Premesso che $p_{sì1}=\frac{a}{a+c}$
$H_0$: le frequenze marginali sono uguali
$H_1$: le frequenze marginali sono diverse
17
Relazione tra variabili qualitative (o quantitative divise in classi). Test di McNemar: statistica test e confronto con valore $\chi^2$ tabulato
Il test viene condotto sulla diagonale di discordanza
$Q=\frac{(|b-c|-1)^2}{b+c}$
Il risultato così ottenuto va confrontato con il risultato tabulato di $\chi^2$. Posto $\alpha=0,05$, si cerca sulla tavola $\chi^2$ il valore tabulato per $g.l.=(r-1)(c-1)$
Se $Q>\chi^2$ e quindi il valore calcolato si alloca nella zona di rifiuto, si può rifiutare ipotesi nulla, accettare ipotesi alternativa. -> Decisione clinica: la procedura considerata ha bassa concordanza
18
Indice K di concordanza di Cohen
Permette di disporre di un indice descrittivo del grado di concordanza tra due sistemi (es. due medici che eseguono lo stesso esame obiettivo).
Indice K ha un valore massimo di 1: se tende a uno, i due sistemi di giudizio tendono alla massima concordanza.
Indice K ha una valore minimo di -1: se tende a -1 si può pensare a un fenomeno di "concordanza nella discordanza".
Indice K ha un valore massimo di 1: se tende a uno, i due sistemi di giudizio tendono alla massima concordanza.
Indice K ha una valore minimo di -1: se tende a -1 si può pensare a un fenomeno di "concordanza nella discordanza".
19
Indice K di concordanza di Cohen: interpretazione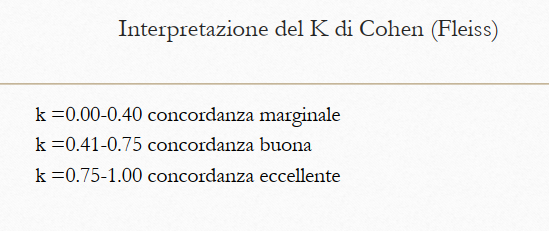
Se k tende a 0, la concordanza è solo legata all'effetto del caso.
Nelle pubblicazioni in genere si fa riferimento sia al risultato del test di McNemar, sia all'indice di Cohen. Nel caso in cui quest'ultimo sia molto alto, spesso viene omesso il risultato del test di McNemar.
Nelle pubblicazioni in genere si fa riferimento sia al risultato del test di McNemar, sia all'indice di Cohen. Nel caso in cui quest'ultimo sia molto alto, spesso viene omesso il risultato del test di McNemar.
20
Indice K di concordanza di Cohen - calcolo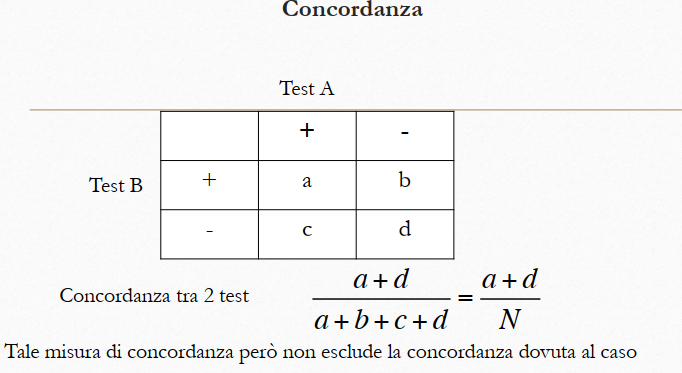
1. Si determina la percentuale di risultati concordanti $I_o$
$I_o=\frac{(a+d)}{N}$
2. Si determina il valore atteso di concordanza $I_e$
$I_e=\frac{[(a+b)(a+c)] + [(b+d)(c+d)]}{N^2}$
3. Determino k
$k = \frac {I_o - I_e}{1-I_e}$
$I_o=\frac{(a+d)}{N}$
2. Si determina il valore atteso di concordanza $I_e$
$I_e=\frac{[(a+b)(a+c)] + [(b+d)(c+d)]}{N^2}$
3. Determino k
$k = \frac {I_o - I_e}{1-I_e}$
21
$\chi^2$ per il trend 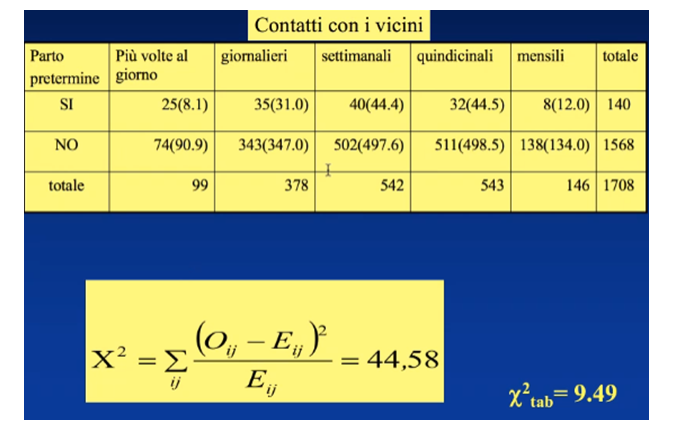
Nel caso di una tabella $2 \cdot k$, nel caso in cui:
1) una variabile è dicotomica ($2$ possibili valori)
2) l'altra è una variabile qualitativa ordinale con $k$ modalità
allora può nascere l'esigenza, se si rifiuta $H_0$ e si conclude che le proporzioni non sono uguali, di studiare se esiste un trend (un andamento), da verificare con un secondo test, appunto $\chi^2$ per il trend.
In altre parole: è possibile valutare il trend solo se l'ipotesi nulla del $\chi^2$ generale (ipotesi nulla di uguaglianza della proporzione) viene rifiutata e se la variabile di cui si sta esplorando il ruolo è categorica e ordinale
22
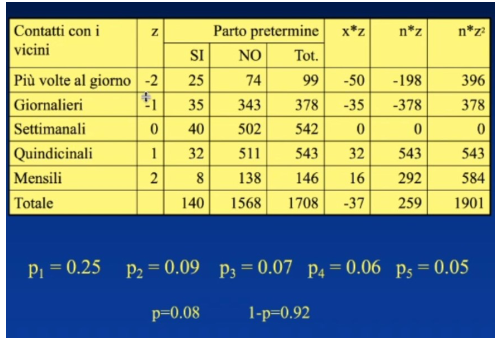
$\chi^2$ per il trend. Costruzione della tabella, attribuzione del punteggio fittizio $z$ alla variabile categorica ordinale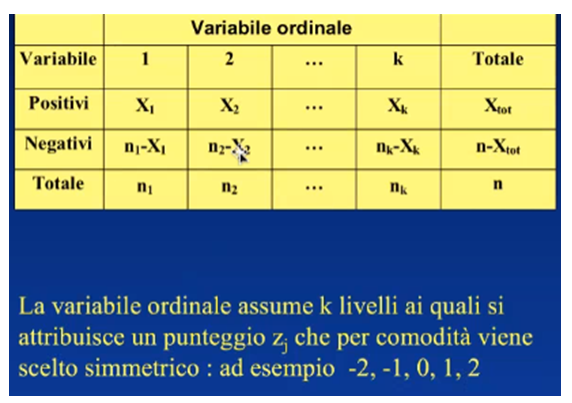
Alla variabile ordinale si attribuiscono punteggi fittizi arbitrari (generalmente da -n a +n, simmetrici, per comodità).
23
$\chi^2$ per il trend. Statistica test
Dopo aver calcolato il valore $\chi_{lin}^2$, si confronta con il valore tabulato per $\alpha=0,05$ e g.d.l.= 1. Ricordare che il trend ha gradi di libertà =1 (v.dopo)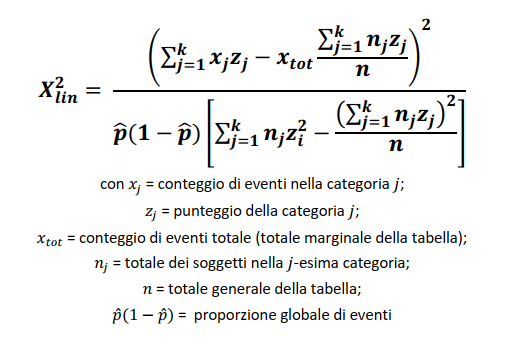
24
$\chi^2$ per il trend. Scomposizione del $chi^2$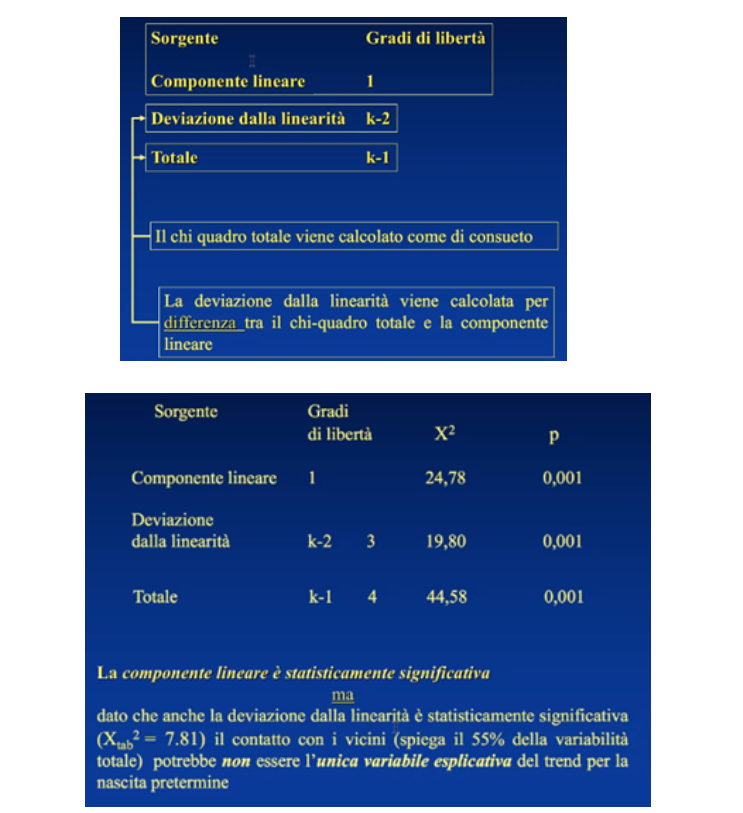
Si può "smembrare" il $\chi^2$ generale in due componenti:
- componente lineare, legata all'esistenza del trend (si calcola con la statistica test $\chi_{lin}^2$
- componente residua non lineare (deviazione dalla linearità), legata alla variabilità, non spiegata dal trend della variabile in studio
- componente lineare, legata all'esistenza del trend (si calcola con la statistica test $\chi_{lin}^2$
- componente residua non lineare (deviazione dalla linearità), legata alla variabilità, non spiegata dal trend della variabile in studio