5.Inferenza stat.Stime e int. di confid.
Study these flashcardsFree · spaced repetition · iPhone, Android, Mac & web
All cards
1
Parametro e stima di un parametro
Nelle applicazioni pratiche quasi sempre i valori dei parametri di una popolazione non sono noti. In questi casi bisogna stimare alcune caratteristiche (= i parametri) di una popolazione utilizzando i dati contenuti in un campione di osservazioni.
Questo processo è noto come inferenza statistica.
Parametri: indicati con lettere greche es. $\mu, \sigma$
Stime di parametro: indicate con lettere greche con il trattino sopra o lettera italica con il circonflesso es. $\bar{\mu}, \hat{p}$
Questo processo è noto come inferenza statistica.
Parametri: indicati con lettere greche es. $\mu, \sigma$
Stime di parametro: indicate con lettere greche con il trattino sopra o lettera italica con il circonflesso es. $\bar{\mu}, \hat{p}$
2
Statistica inferenziale
La statistica inferenziale è l'insieme di metodi usati per quantificare la probabilità che una deduzione basata sull'analisi dei dati raccolti per un campione sia vera: permette di estendere i risultati ottenuti dal campione a tutta la popolazione.
Stima dei parametri + verifica delle ipotesi
Stima dei parametri + verifica delle ipotesi
3
Teorema del limite centrale. Distribuzione campionaria delle medie dei campioni
Assumendo che in una determinata popolazione una variabile casuale continua abbia media $\mu$ e deviazione standard $\sigma$.
Si seleziona un campione casuale di $n$ osservazioni dalla popolazione e si calcola la media del campione $\bar{x}_1$.
Se si seleziona un secondo campione si avrà una media $\bar{x}_2$.
Se si selezionano n campioni, si ottiene una serie di n valori costituiti da medie campionarie. Si descrive quindi una variabile casuale con risultati dati dalle osservazioni $\bar{x}_1, \bar{x}_2, \bar{x}_3, ..., \bar{x}_n$ che avrà una sua distrubzione di probabilità, distribuzione campionaria delle medie di campioni-
Nella pratica non si selezionano campioni ripetuti di dimensione n da una popolazione, ma conoscere le proprietà delle della distribuzione teorica delle loro medie consente di fare inferenza partendo da un singolo campione di dimensione $n$.
4
Teorema del limite centrale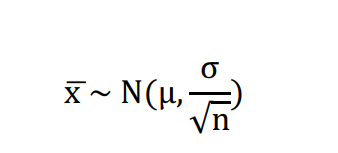
Posta una variabile casuale della popolazione con media $\mu$ e deviazione standard $\sigma$, la distribuzione delle medie campionarie calcolata per campioni di dimensione $n$ ha tre importanti proprietà:
1. la media della distribuzione campionaria è uguale alla media $\mu$ della popolazione
2. la deviazione standard della distribuzione delle medie campionarie è uguale a $\frac{\sigma}{\sqrt{n}}$ (variabilità campionaria)
3. la forma della distribuzione campionaria è approssimativamente normale, posto che n sia sufficientemente grande (v. immagine e nota)
Altra formulazione del teorema:
In condizioni abbastanza generali (anche per popolazioni originarie in cui variabile non ha distribuzione di Gauss), somme e medie di misurazioni casuali ricavate da una popolazione (= campioni) tendono a possedere una distribuzione normale con media = $\mu$ e varianza = $\frac{\sigma^2}{n}$ (d.s. =$ \frac{\sigma}{\sqrt{n}}\ $)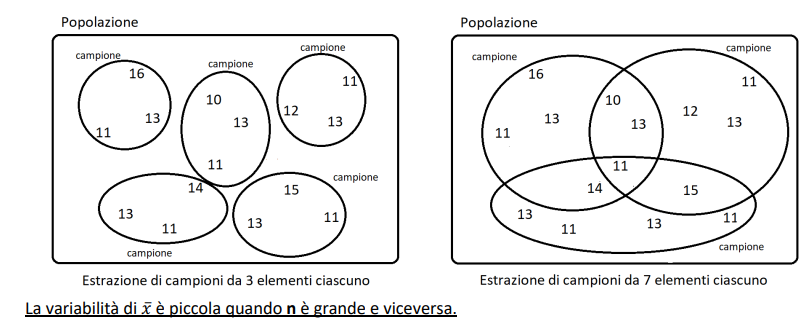
1. la media della distribuzione campionaria è uguale alla media $\mu$ della popolazione
2. la deviazione standard della distribuzione delle medie campionarie è uguale a $\frac{\sigma}{\sqrt{n}}$ (variabilità campionaria)
3. la forma della distribuzione campionaria è approssimativamente normale, posto che n sia sufficientemente grande (v. immagine e nota)
Altra formulazione del teorema:
In condizioni abbastanza generali (anche per popolazioni originarie in cui variabile non ha distribuzione di Gauss), somme e medie di misurazioni casuali ricavate da una popolazione (= campioni) tendono a possedere una distribuzione normale con media = $\mu$ e varianza = $\frac{\sigma^2}{n}$ (d.s. =$ \frac{\sigma}{\sqrt{n}}\ $)
5
Stima puntuale e stima di intervallo
Stima puntuale: si calcola un singolo valore numerico per stimare un singolo valore.
Stima di intervallo (intervallo di confidenza): si calcola un intervallo di valori che con un certo grato di probabilità conterrà il parametro da stimare. In questo modo si ottiene un range di possibili valori etro i quali si ritiene - con un certo grado di confidenza - che sia compreso il parametro.
Stima di intervallo (intervallo di confidenza): si calcola un intervallo di valori che con un certo grato di probabilità conterrà il parametro da stimare. In questo modo si ottiene un range di possibili valori etro i quali si ritiene - con un certo grado di confidenza - che sia compreso il parametro.
6
Intervalli di confidenza
Le stime di intervallo forniscono informazioni sia sul valore del parametro sia sul grado di attendibilità di quella stima (una probabilità).
$1- \alpha = P(L_1 \leq \theta \leq L_2)$ con $0 \leq \alpha \leq 1$
- theta è un parametro generico della popolazione (media, varianza, proporzione)
- 1-alfa è il livello di confidenza, ossia la probabilità che il parametro theta sia compreso tra i limiti dell'intervallo L1 e L2
$1- \alpha = P(L_1 \leq \theta \leq L_2)$ con $0 \leq \alpha \leq 1$
- theta è un parametro generico della popolazione (media, varianza, proporzione)
- 1-alfa è il livello di confidenza, ossia la probabilità che il parametro theta sia compreso tra i limiti dell'intervallo L1 e L2
7
Interpretazione dell'intervallo di confidenza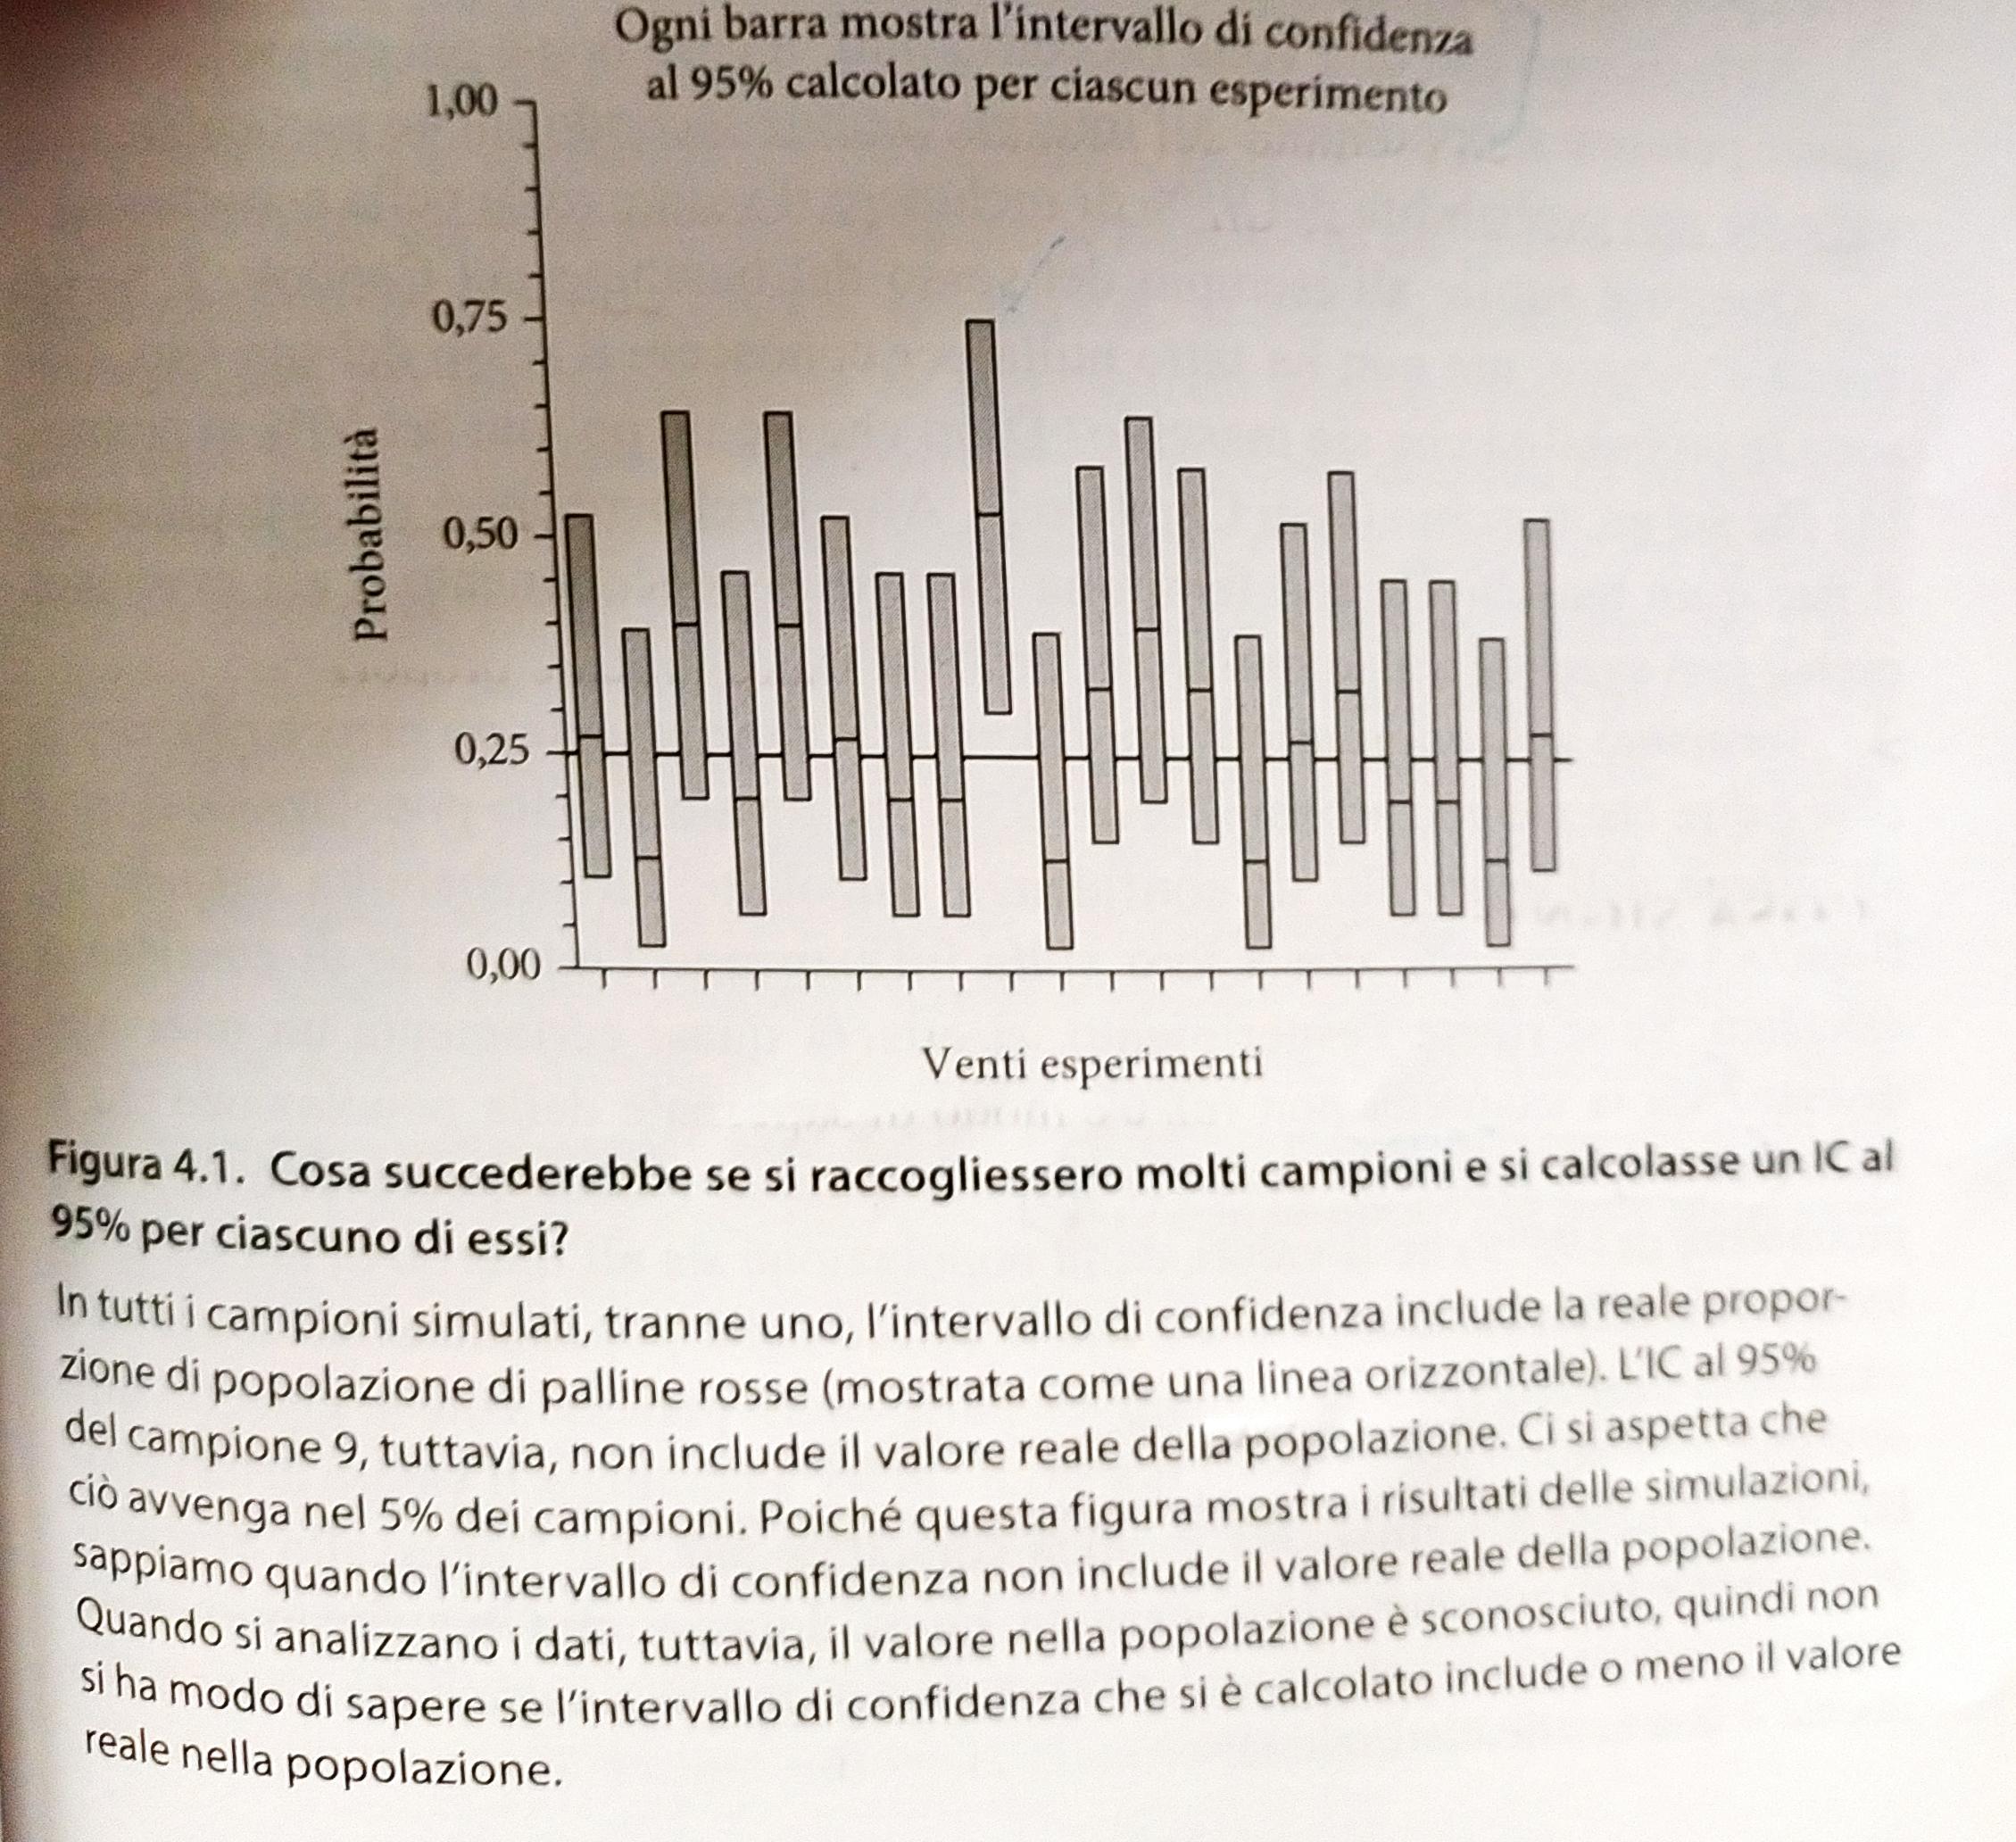
Una volta individuato l'intervallo di confidenza per un parametro, questa conclusione
NON SIGNIFICA:
- che il parametro è compreso nell'intervallo $1-\alpha\%$ delle volte
- che $1- \alpha\%$ dei valori della popolazione è compreso in questo intervallo
Ma
SIGNIFICA:
- che c'è una probabilità del $1-\alpha\%$ che l'intervallo di confidenza contenga il parametro della popolazione (interpretazione pratica)
- che se si estraggono 100 campioni da una popolazione distribuita normalmente e si calcolano 100 intervalli di confidenza, $1-\alpha\%$ di questi contengono il parametro, $\alpha\%$ no (interpretazione probabilistica).
8
Intervallo di confidenza per unaa media. Varianza nota. (1)
Si suppone che la varibile casuale per cui si sta calcolando la stima segua la distribuzione di Gauss. La deviazione standard $\sigma$ è nota.
$1- \alpha = P(L_1 \leq \mu \leq L_2)$ con $0 \leq \alpha \leq 1$
Devo individuare i valori di L1 e L2 che garantiscano che, estraendo dalla popolazione altri campioni di uguale dimensione n, con probabilità = 95% la media campionaria sia contenuta nell'intervallo.
$1- \alpha = P(L_1 \leq \mu \leq L_2)$ con $0 \leq \alpha \leq 1$
Devo individuare i valori di L1 e L2 che garantiscano che, estraendo dalla popolazione altri campioni di uguale dimensione n, con probabilità = 95% la media campionaria sia contenuta nell'intervallo.
9
Intervallo di confidenza per una media. Varianza nota. (2)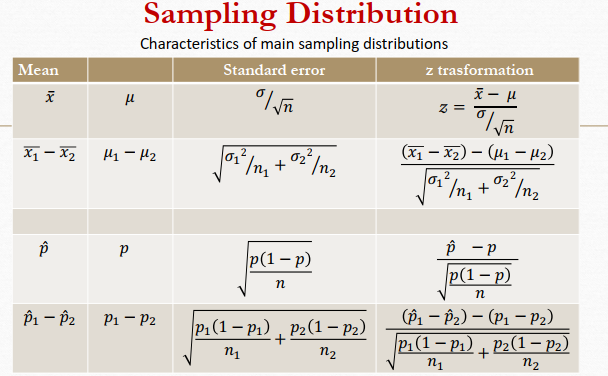
$1- \alpha = P(L_1 \leq \mu \leq L_2)$ con $0 \leq \alpha \leq 1$
Voglio ottenere un intervallo di confidenza per il parametro della media della popolazione: come?
Dopo aver eseguito sul campione la stima puntuale $\bar{x}$ della media della variabile X. Data l'assunzione iniziale per cui X segue una distribuzione di Gauss, posso standardizzare questa variabile in una "nuova" variabile Z che segue una distribuzione di Gauss standard (tabulata, con media = 0, d.s.=1)
$z = \frac{\bar{x}- \mu}{\frac{\sigma}{\sqrt{n}}}$
Ricorda che in generale la standardizzazione di una generica variabile X in una variabile Z è data dalla trasformazione
$Z = \frac{X - \mu}{\sigma}$
10
Intervallo di confidenza per una media. Varianza nota. (3)
Sviluppo della disequazione (scriverlo)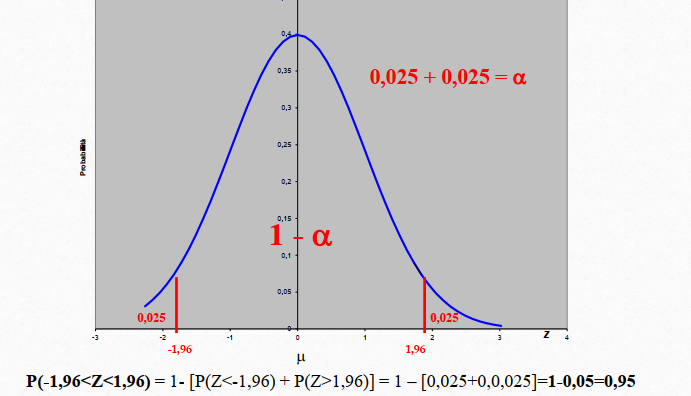
Sviluppo della disequazione (scriverlo)
La variabile segue una distribuzione di Gauss standard (simmetrica rispetto a zero), quindi si può trasformare L1 e L2 in -L e +L (uguali e opposti).
-L e +L si possono sostituire con i valori di $z_{tab}$ ricavabili dalle tavole della distribuzione di Gauss standard
Per $1-\alpha =0,95$ cioè $\alpha=0,05$ si ha $z_{tab} = \pm1,96$
Per $1-\alpha =0,99$ cioè $\alpha=0,01$ si ha $z_{tab} = \pm2,58$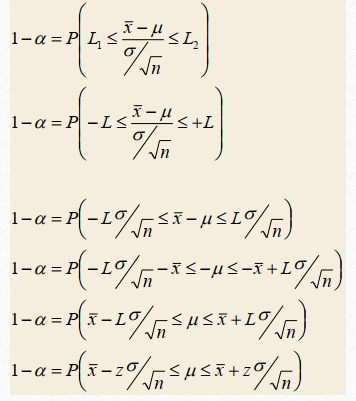
-L e +L si possono sostituire con i valori di $z_{tab}$ ricavabili dalle tavole della distribuzione di Gauss standard
Per $1-\alpha =0,95$ cioè $\alpha=0,05$ si ha $z_{tab} = \pm1,96$
Per $1-\alpha =0,99$ cioè $\alpha=0,01$ si ha $z_{tab} = \pm2,58$
11
Intervallo di confidenza per una media. Varianza ignota.
Distribuzione t-Student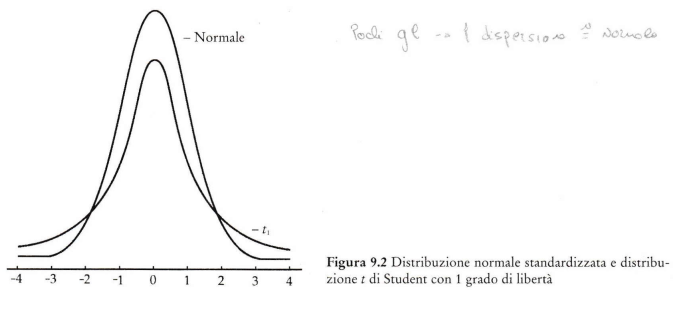
Distribuzione t-Student
Molto spesso quando non è nota la media $\mu$di una popolazione, anche la deviazione standard $\sigma$ non è nota.
Non si utilizza la distribuzione normale standardizzata ($z$) ma si usa una nuova distribuzione di probabilità: distribuzione t di Student.
Ricordando che
$Z= \frac{\bar{X} - \mu}{\sigma/ \sqrt{n}}$
sembra intuitivo e logico sostituire a $\sigma$ (la d.s. della popolazione) la deviazione standard calcolata sul campione $s$
ottenendo la distribuzione t-Student
$t= \frac{\bar{X} - \mu}{s/ \sqrt{n}}$
12
Intervallo di confidenza per una media. Varianza ignota.
Distribuzione t-Student: proprietà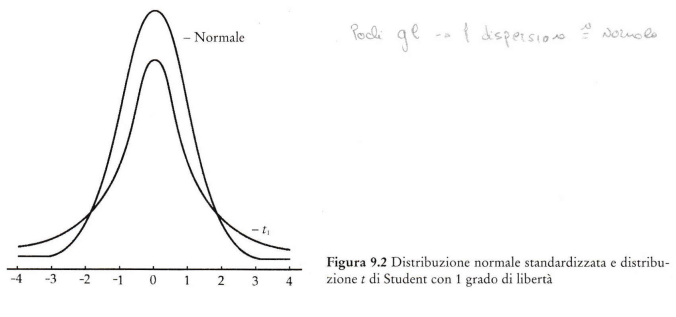
Distribuzione t-Student: proprietà
- Ha la stessa forma della distribuzione di Gauss, ha code più spesse e valori estremi sono più probabili
- Simmetrica intorno alla media
- Media = 0
- Ha varianza >1 che si avvicina a 1 per $n \rightarrow \infty$
- Esiste una famiglia di distribuzioni t-student distinte dai gradi di libertà (per ogni valore dei gradi di libertà esiste una diversa distribuzione t)
- La distribuzione t-student diventa sempre più approssimabile alla normale standardizzata, N(0,1), all'aumentare della dimensione del campione cioè quando la deviazione standard del campione diventa una sempre più affidabile della deviazione standard del campione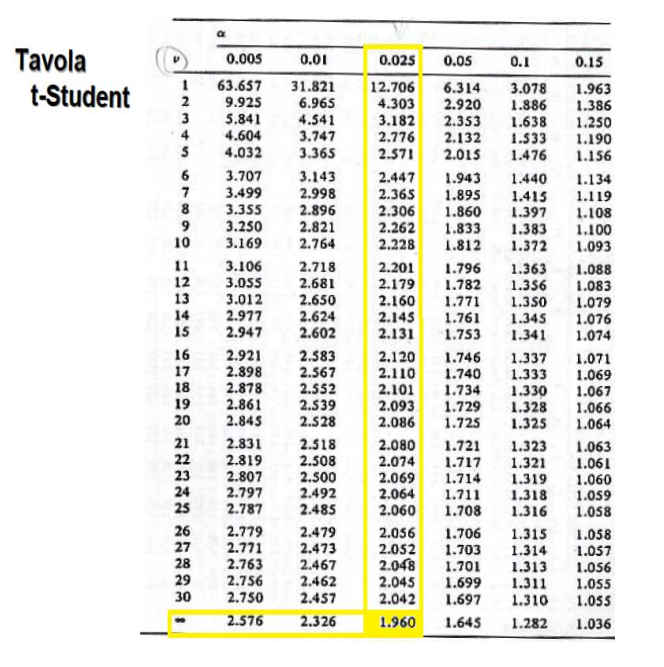
- Simmetrica intorno alla media
- Media = 0
- Ha varianza >1 che si avvicina a 1 per $n \rightarrow \infty$
- Esiste una famiglia di distribuzioni t-student distinte dai gradi di libertà (per ogni valore dei gradi di libertà esiste una diversa distribuzione t)
- La distribuzione t-student diventa sempre più approssimabile alla normale standardizzata, N(0,1), all'aumentare della dimensione del campione cioè quando la deviazione standard del campione diventa una sempre più affidabile della deviazione standard del campione
13
Intervallo di confidenza per una media. Varianza ignota. Sviluppo della disequazione (scrivere)
Partendo dall'equazione $1-\alpha=P(L_1 \leq \mu \leq L_2)$
Si sostituisce
$\mu$ con la variabile $t$
$L_1$ con $c_1$
$L_2$ con $c_2$
Si sviluppa l'equazione fino ad ottenere
$1- \alpha = P(\bar{x} -t\frac{S}{\sqrt{n}} \leq \mu \leq \bar{x} +t\frac{S}{\sqrt{n}}) $
con
$\bar{x}$ = media del campione
$t$ = fattore di correzione (tabulato dati alfa e gradi di libertà)
$S$ = deviazione standard campionaria
$n$ = numerosità campionaria
$\frac{s}{\sqrt{n}}$ = errore standard della stima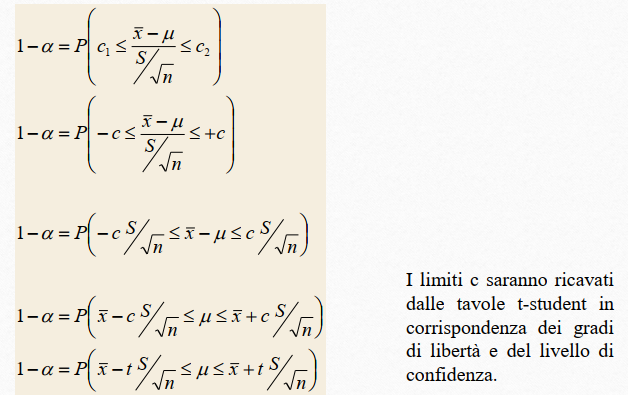
Si sostituisce
$\mu$ con la variabile $t$
$L_1$ con $c_1$
$L_2$ con $c_2$
Si sviluppa l'equazione fino ad ottenere
$1- \alpha = P(\bar{x} -t\frac{S}{\sqrt{n}} \leq \mu \leq \bar{x} +t\frac{S}{\sqrt{n}}) $
con
$\bar{x}$ = media del campione
$t$ = fattore di correzione (tabulato dati alfa e gradi di libertà)
$S$ = deviazione standard campionaria
$n$ = numerosità campionaria
$\frac{s}{\sqrt{n}}$ = errore standard della stima
14
Ritornando sulle stime di intervallo: una formula generica. Considerazioni su errore standard
Intervallo = Stima $\pm$ (fattore di correzione $\times$ errore standard della stima)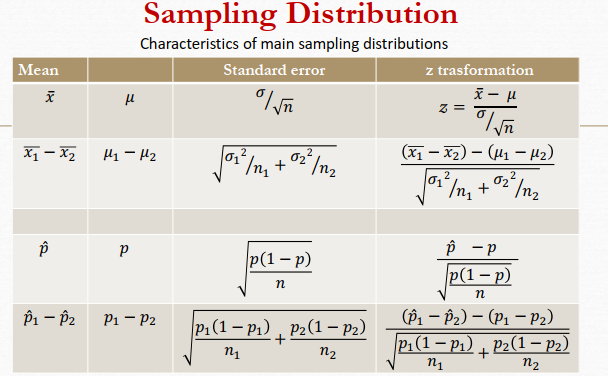
Intervallo = Stima $\pm$ (fattore di correzione $\times$ errore standard della stima)
Un intervallo di confidenza si costruisce conoscendo
- la stima del parametro $\bar{x}$ calcolata sul campione
- il fattore di correzione o valore critico, che serve a determinare i limiti dell'intervallo tenendo conto del grado di attendibilità richiesto e del tipo di distribuzione (gaussiana standard o t-Student), rappresentato con $z$ o $t$ (rintracciabile sulle tavole)
- errore standard, corrispondente a $\frac{\sigma}{\sqrt{n}}$ (quando d.s. della popolazione è nota) o $\frac{S}{\sqrt{n}}$ (quando d.s. della popolazione incognita)
Come si vede errore standard è direttamente proporzionale all'indice di dispersione, inversamente proporzionale alla numerosità campionaria.
15
Intervallo di confidenza per la differenza di due medie. Varianza nota. 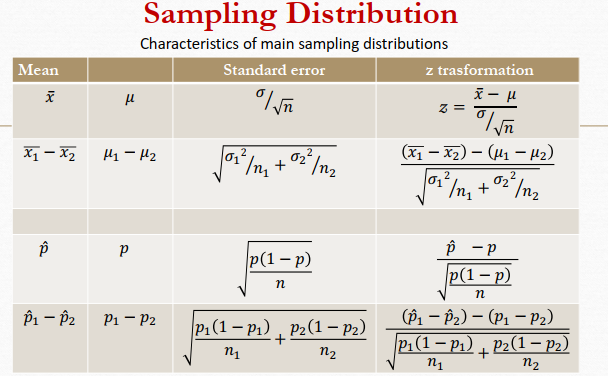
Si determinano le medie della variabile in due campioni.
$\mu_1 - \mu2$ = differenza delle medie delle popolazioni
$\bar{x}_1 - \bar{x}_2$ = stima (campionaria) della differenza delle medie delle popolazioni
$\frac{\sigma_1^2}{n_1}+\frac{\sigma_2^2}{n_2}$= varianza della differenza delle medie campionarie (ricorda: variabile X con varianza $\sigma^2$ viene standardizzata in un'altra variabile Z con varianza $\sigma^2/n$ )
Sviluppando l'equazione si ottiene infine l'intervallo:
$ 1 - \alpha = P[ (\bar{x}_1 - \bar{x}_2) - z\sqrt{\frac{\sigma_1^2}{n_1}+\frac{\sigma_2^2}{n_2}} \leq \mu_1 - \mu_2 \leq (\bar{x}_1 - \bar{x}_2) + z\sqrt{\frac{\sigma_1^2}{n_1}+\frac{\sigma_2^2}{n_2}}]$
Si può usare z perché la varianza della popolazione è nota.
Errore della stima in questo intervallo è:
$\sqrt{\frac{\sigma_1^2}{n_1}+\frac{\sigma_2^2}{n_2}}$
16
Intervallo di confidenza per la differenza di due medie. Varianza ignota.
Se non si conosce la varianza della popolazione, dai campioni si stima la varianza comune (o pooled):
$S_p^2=\frac{S_1^2(n_1-1)+S_2^2(n_2-1)}{n_1+n_2-2} $
$n_1 + n_2 - 2$ = gradi di libertà per la varianza pooled
Intervallo di confidenza diventa:
$ 1 - \alpha = P[ (\bar{x}_1 - \bar{x}_2) - t\sqrt{\frac{S_p^2}{n_1}+\frac{S_p^2}{n_2}} \leq \mu_1 - \mu_2 \leq (\bar{x}_1 - \bar{x}_2) + t\sqrt{\frac{S_p^2}{n_1}+\frac{S_p^2}{n_2}}]$
17
Intervalli di confidenza per una proporzione. (1)
In medicina spesso si quantifica un fenomeno per mezzo di percentuali.
Il parametro da stimare diventa p, la proporzione della popolazione
$1- \alpha = P (L_1 \leq p \leq L_2)$
La variabile X che conta il numero di successi sul numero di prove ha una distribuzione binomiale con $\mu=np$ e $\sigma^2= np(1-p)$.
Quindi:
- può essere approssimata ad una distribuzione di Gauss assumendo $n \rightarrow \infty$ (in pratica n ragionevolment grande) e $p \cong 0,5$
- può essere standardizzata
18
Intervalli di confidenza per una proporzione. (2)
Sviluppo della disequazione
Sviluppo della disequazione
$z = \frac{X - \mu}{\sigma} = \frac {X - np}{\sqrt{np(1-p)}}$
Dato $1 - \alpha = P (L_1 \leq p \leq L_2)$
Sostituiamo la variabile p con la variabile z
$1-\alpha = P( L_1 \leq \frac {X-np}{\sqrt{np(1-p)}} \leq L_2)$
Sostituiamo $L_1$ e $L_2$ con $- c$ e $+ c$ (la variabile z segue una distribuzione di Gauss standard = simmetrica rispetto alla media 0 quindi i limiti dell'intervallo sono uguali e opposti)
$1-\alpha = P( -c \leq \frac {X-np}{\sqrt{np(1-p)}} \leq +c)$
19
Intervalli di confidenza per una proporzione. (3)
Sviluppo della disequazione
Sviluppo della disequazione
Il parametro d'interesse $p$ si trova al numeratore e al denominatore, oltreché sotto radice
Bisogna razionalizzare la frazione elevando al quadrato
$1-\alpha = P [(\frac{X - np}{\sqrt{np(1-p)}})^2 \leq c^2]$
$1 - \alpha = P [\frac{X^2 +n^2p^2 - 2npX}{np(1-p)} \leq c^2]$
La risoluzione della disequazione di secondo grado nell'incognita p ha come soluzioni
$p_{1,2}= \frac{X}{n}\pm \frac{c}{n}\left ( \sqrt{\frac{X}{n}(n-X)} \right )$
Per n sufficientemetnte grande l'intervallo si approssima
$1 - \alpha = P \left [ \hat{p} -z_{1-\alpha/2} \sqrt{\frac{\hat{p} (1- \hat{p})}{n}} \leq p \leq \hat{p} +z_{1-\alpha/2} \sqrt{\frac{\hat{p} (1- \hat{p})}{n}} \right ]$
$\sqrt{\frac{\hat{p} (1- \hat{p})}{n}}$ = errore della stima
20
Intervalli di confidenza per la differenza tra due proporzioni.
Durante uno studio si vuole confrontare la differenza tra tra due proporzioni.
Il parametro da stimare è $p_1 - p_2$
La stima di intervallo si ottiene mediante l'espressione seguente:
$1 - \alpha = P \left [ (\hat{p_1} - \hat{p_2}) -z\sqrt{\frac{\hat{p_1} (1- \hat{p_1})}{n_1} + \frac{\hat{p_2} (1- \hat{p_2})}{n_2}} \leq p_1-p_2 \leq (\hat{p_1} - \hat{p_2}) +z\sqrt{\frac{\hat{p_1} (1- \hat{p_1})}{n_1} + \frac{\hat{p_2} (1- \hat{p_2})}{n_2}} \right ]$
L'errore della stima in questo caso è:
$\sqrt{\frac{\hat{p_1} (1- \hat{p_1})}{n_1} + \frac{\hat{p_2} (1- \hat{p_2})}{n_2}}$